PHP Packages Graph
Cartographier les dépendances et la maintenance des paquets Packagist
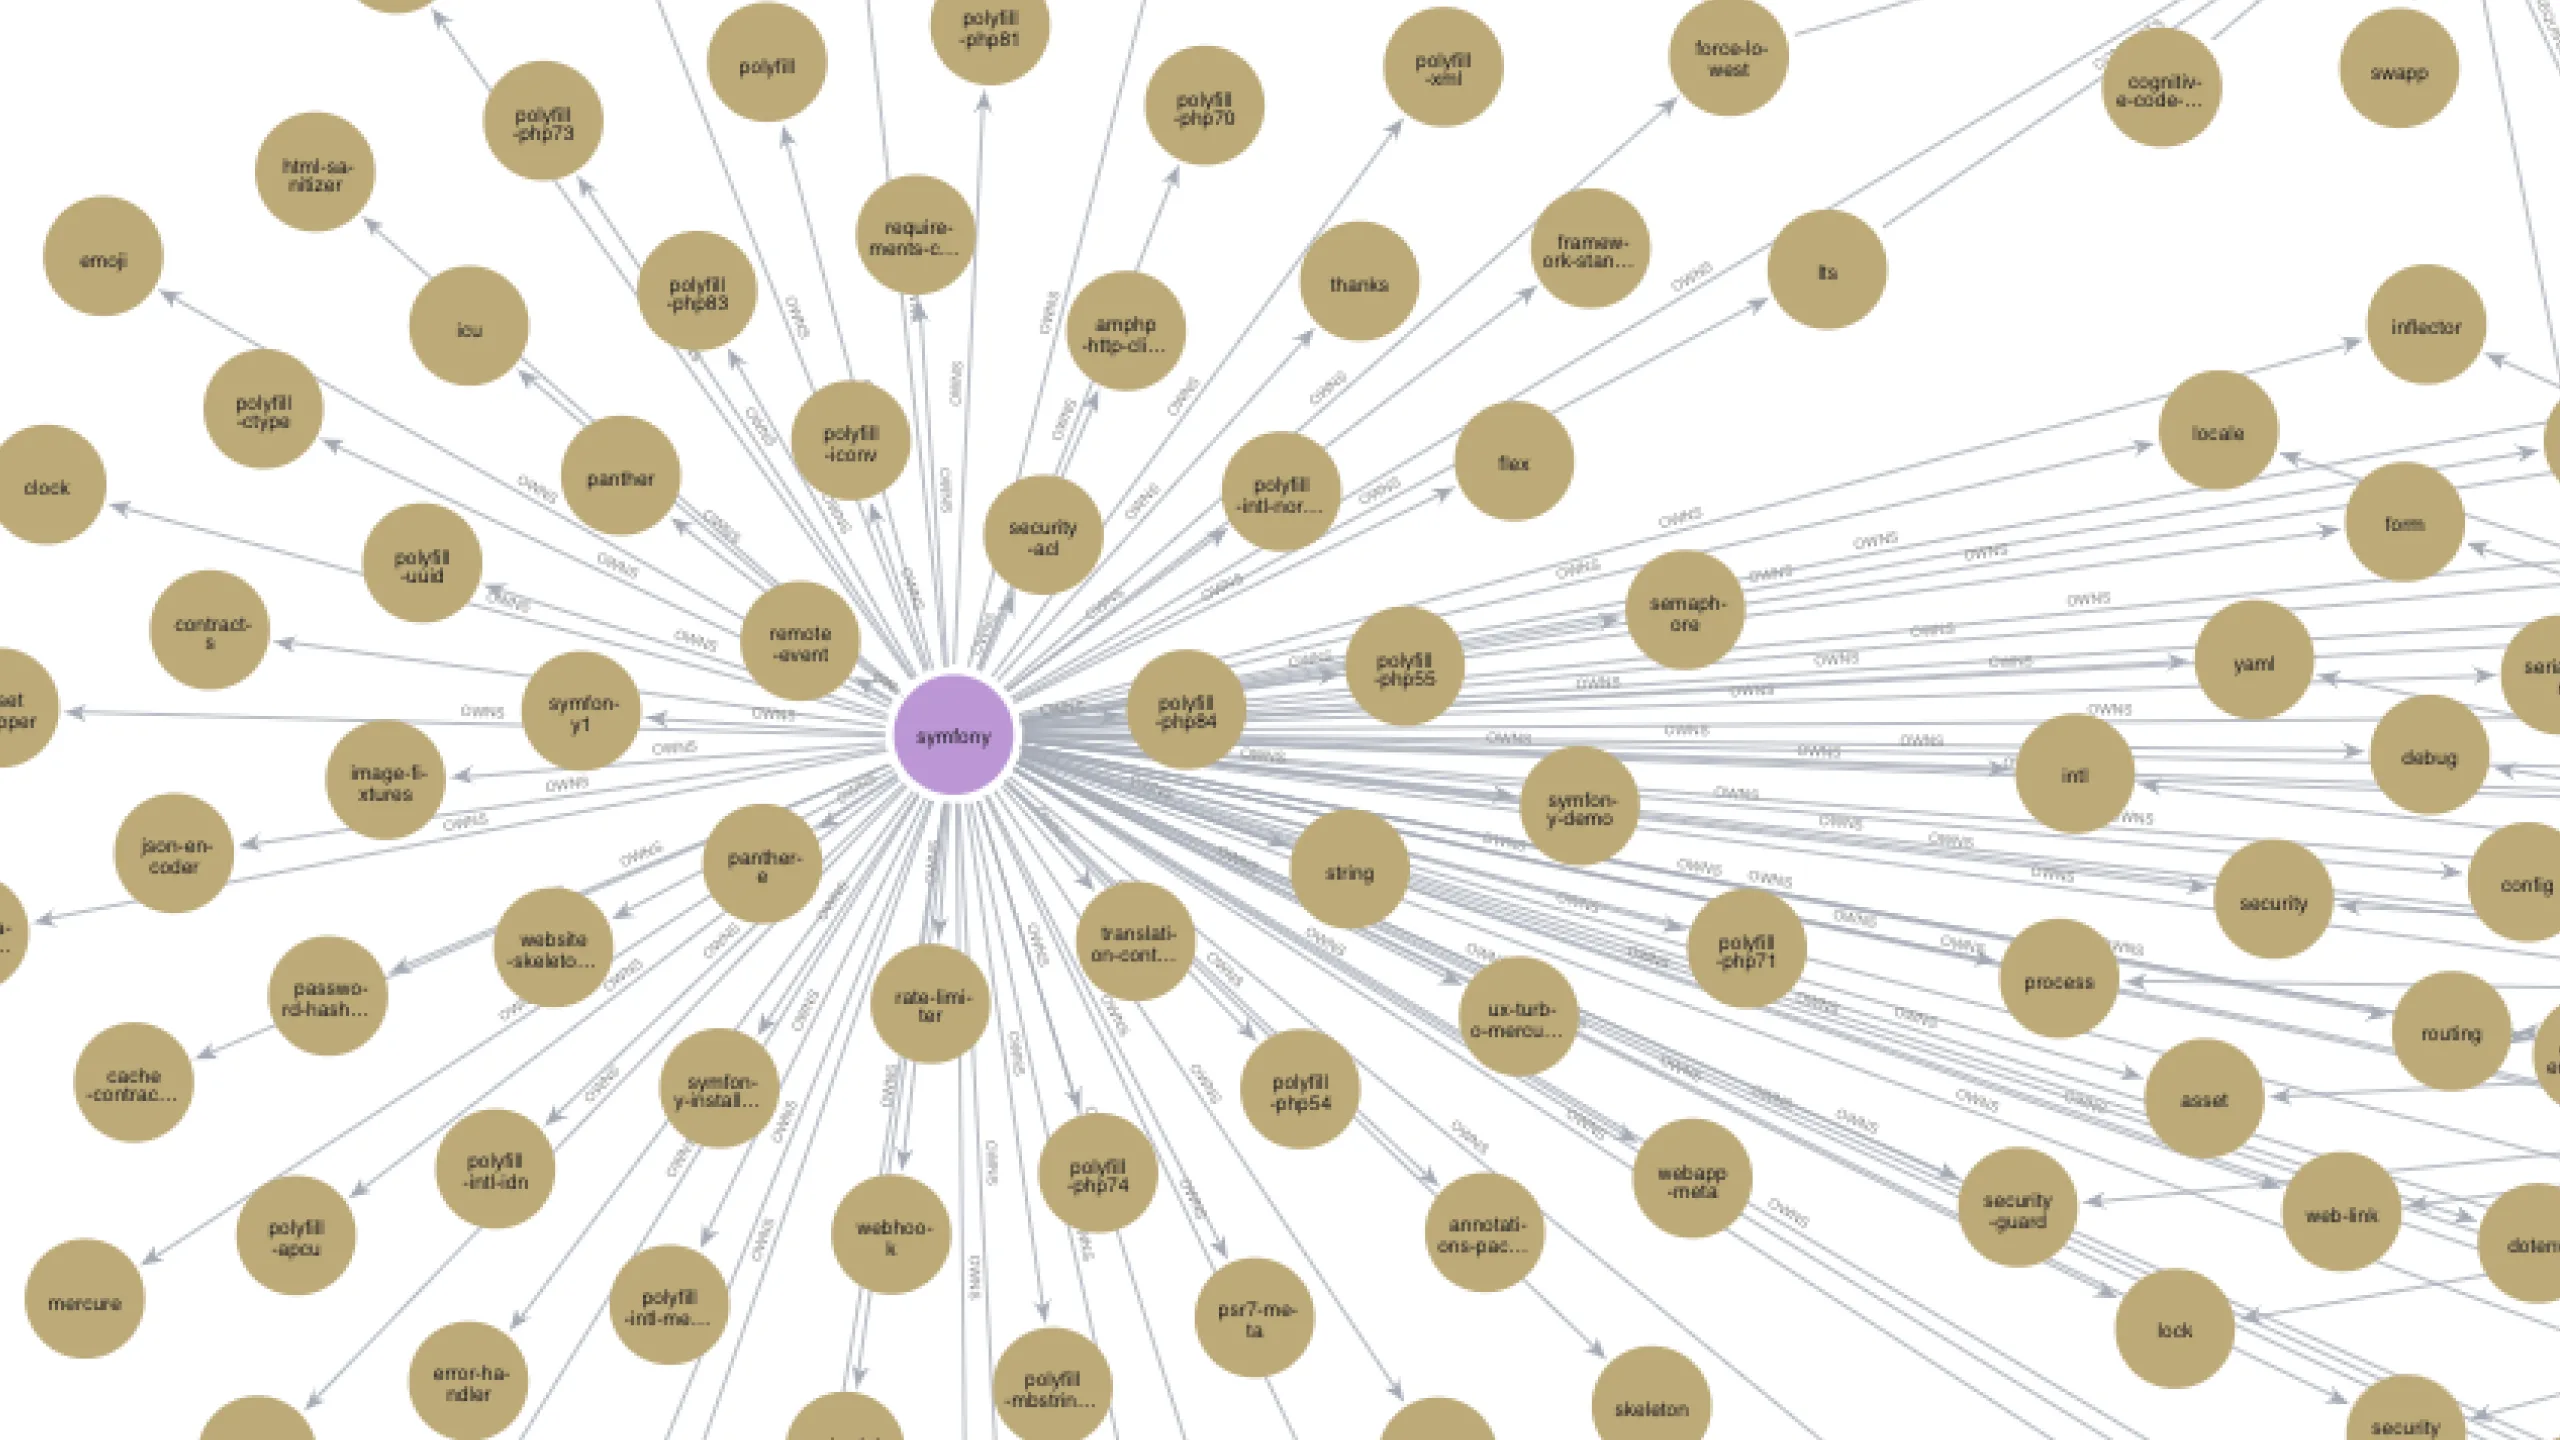
PHP Packages Graph est un projet de recherche sur la structure de l’écosystème des paquets PHP. Il collecte les métadonnées Composer depuis Packagist et stocke les paquets, les fournisseurs et les types de dépendances dans Neo4j.
Le nombre de téléchargements explique peu la place d’un paquet dans le réseau. Un graphe permet de comparer les dépendances d’exécution et de développement, d’examiner les paquets abandonnés dont dépendent de nombreux projets et d’étudier les licences ou les indicateurs de maintenance dans leur contexte.
Le problème
Packagist rend les métadonnées disponibles et Composer résout les dépendances de chaque projet. Aucun des deux n’a pour rôle d’expliquer la structure de tout l’écosystème.
Packagist et Composer facilitent l’installation des paquets, mais ne répondent pas directement aux questions plus profondes sur l’écosystème :
Un gestionnaire de paquets sait très bien résoudre les dépendances d’un projet. Il n’est pas conçu pour expliquer la structure des dépendances d’un écosystème entier.
Cette distinction compte, car les applications PHP modernes dépendent souvent de dizaines, voire de centaines de paquets directs et transitifs. Certaines bibliothèques deviennent une infrastructure invisible. Elles ne sont pas nécessairement visibles dans le produit, mais soutiennent une grande partie de l’écosystème.
En pratique, comprendre l’écosystème PHP devient un problème de graphe.
Un paquet peut en requérir un autre. Un fournisseur peut posséder de nombreux paquets. Un paquet peut entrer en conflit avec un autre, le remplacer, le fournir, le suggérer ou n’en dépendre que pour le développement. Ces relations forment la structure de l’écosystème.
PHP Packages Graph est ainsi passé d’un simple script de collecte de données Packagist à un système de recherche fondé sur les graphes.
Orientation de la recherche
PHP Packages Graph est parti d’une idée simple :
Construire un graphe de dépendances des paquets PHP publiés sur Packagist.
Cette idée a rapidement pris de l’ampleur. Pour être utile, le système devait faire plus que récupérer les fichiers JSON des paquets. Il devait :
-
collecter les noms des paquets depuis Packagist ;
-
récupérer les métadonnées détaillées des paquets ;
-
stocker le jeu de données brut localement afin de pouvoir le rejouer et l’examiner ;
-
normaliser les données des paquets entre leurs différentes versions ;
-
extraire les dépendances depuis
require,require-dev,conflict,provide,replaceetsuggest; -
modéliser les fournisseurs, les paquets et leurs relations de dépendance dans Neo4j ;
-
conserver les métadonnées utiles, notamment les licences, les auteurs, les téléchargements, les liens vers les dépôts, le type de paquet, son statut d’abandon et ses dates de mise à jour ;
-
rendre le graphe accessible au moyen de requêtes Cypher ;
-
répondre à des questions de recherche sur l’influence, la stabilité, les licences et la maintenance.
Le projet avait donc besoin d’un pipeline reproductible entre les métadonnées de Packagist et un graphe que je puisse reconstruire et interroger.
Architecture du système
PHP Packages Graph utilise quatre étapes :
Le collecteur télécharge les enregistrements. Pydantic valide et agrège les métadonnées des versions. Neo4j stocke les paquets et leurs relations typées. Les requêtes Cypher et les notebooks analysent le graphe.
Le système suit ce flux :
Le JSON enregistré peut être examiné ou rejoué avant tout import dans Neo4j.
Couche de collecte des données
Le collecteur transforme les enregistrements de Packagist en un jeu de données local. Chaque enregistrement contient les versions, les dépendances, les téléchargements, le dépôt, les mainteneurs, les licences et le type du paquet.
Le collecteur suit une règle :
La collecte des données doit être reproductible, pouvoir reprendre après une interruption et rester séparée de l’import dans le graphe.
PHP Packages Graph enregistre les réponses de l’API en JSON local avant tout import dans Neo4j.
Le processus de collecte est simple :
La collecte du registre demande de nombreuses requêtes réseau. Les réponses enregistrées permettent de reprendre un téléchargement interrompu et d’exécuter les imports ou notebooks sans appel d’API en direct.
Collecte de la liste des paquets
La première étape récupère la liste complète des paquets depuis Packagist :
Elle fournit les noms de paquets au format standard de Composer :
vendor/packageCe format devient l’identifiant de référence pour le reste du système.
Le collecteur utilise ensuite le nom de chaque paquet pour récupérer ses métadonnées détaillées :
/packages/{vendor}/{package}.jsonLe collecteur enregistre chaque paquet dans un chemin qui reprend son identité Composer :
packages/vendor/package.jsonLe système de fichiers reprend les noms Composer. vendor/package correspond donc à packages/vendor/package.json.
Récupération incrémentale
Avant chaque récupération, le collecteur vérifie si les informations du paquet existent déjà.
La vérification des fichiers produit ce parcours incrémental :
Récupérer chaque paquet à chaque exécution ferait perdre du temps et de la bande passante.
La version actuelle conserve une stratégie simple, fondée sur des délais d’expiration des requêtes, la vérification de l’existence des fichiers locaux et des options de ligne de commande :
--fetch-list

--fetch-info

--force-update
Cela suffit pour un pipeline de recherche.
Pourquoi la conception de la collecte est importante
Le collecteur enregistre les réponses de l’API. Les modèles, l’import dans le graphe et les requêtes de recherche s’exécutent ensuite :
Chaque étape peut être relancée sur le jeu de données enregistré sans télécharger tous les paquets.
Couche de base de données orientée graphe
Une fois les métadonnées des paquets collectées, le défi suivant concerne leur représentation.
Une table relationnelle peut stocker les enregistrements des paquets. Une base documentaire peut stocker leur JSON. Cependant, les écosystèmes de dépendances sont, par nature, largement structurés par leurs relations.
Neo4j stocke ces relations sous forme d’arêtes, sans obliger chaque analyse à reconstruire des jointures.
La base de données orientée graphe suit une règle :
Modéliser l’écosystème PHP comme un réseau de relations, et non comme une simple liste de paquets.
Le nœud Package se trouve au centre du graphe.
Un paquet appartient à un fournisseur et se connecte à d’autres paquets au moyen des relations de dépendance de Composer :
Ce modèle permet d’interroger l’écosystème sous une forme fidèle au domaine réel des dépendances.
Un paquet est à la fois un enregistrement et un nœud dans un réseau de dépendances.
Choix technologique
PHP Packages Graph utilise Neo4j comme base de données orientée graphe.
Le projet exécute Neo4j avec Docker Compose et active les plugins APOC et Graph Data Science. Ceux-ci constituent une base utile pour l’analyse de graphes et de futurs algorithmes de centralité.
Le service Neo4j local expose :
7474 -> Neo4j Browser

7687 -> Bolt protocol
Le projet dispose ainsi de deux interfaces :
Cette répartition convient bien à un projet de recherche : Python traite les données, tandis que Neo4j assure le stockage du graphe et l’analyse interactive.
Modèle principal du graphe
Le premier import dans le graphe crée deux types de nœuds :
Vendor

Package
ainsi qu’une relation de propriété :
(v:Vendor)-[:OWNS]->(p:Package)Le nœud du paquet stocke son nom Composer canonique :
full_name: vendor/packageCette propriété devient la clé de recherche principale pour l’enrichissement ultérieur et la mise en correspondance des dépendances.
L’importateur crée également des contraintes d’unicité :
Vendor.name

Package.full_name
C’est important, car les imports dans le graphe doivent pouvoir être réexécutés sans risque.
Sans contraintes d’unicité, la base pourrait créer silencieusement des fournisseurs ou des nœuds de paquets en double. Grâce aux contraintes et à MERGE, les imports deviennent plus prévisibles et idempotents.
Schéma du graphe
Le schéma du graphe peut être représenté comme un modèle compact de l’écosystème :
Ce schéma maintient un modèle simple tout en préservant les relations nécessaires à l’analyse de l’écosystème.
Le paquet comme objet de connaissance canonique
Après la création des nœuds initiaux, la couche de mise en correspondance enrichit chaque nœud de paquet avec des métadonnées :
description

published_at

updated_at

licenses

versions

authors

repository

github_stars

github_watchers

github_forks

github_open_issues

language

abandoned

downloads

type

has_stable_release

is_custom_type
Chaque nœud Package devient ainsi un objet de connaissance compact.
Le graphe ne sait pas seulement qu’un paquet existe. Il peut aussi stocker son type, la présence de versions stables, les licences utilisées selon les versions, son nombre de téléchargements, ses dates de publication et de dernière mise à jour, ainsi que son éventuel abandon.
C’est cette combinaison qui rend le graphe utile à la recherche.
Les relations de dépendance expliquent la structure. Les propriétés des paquets apportent le contexte.
Couche de modélisation et de normalisation
Les métadonnées des paquets Packagist sont imbriquées, versionnées et ne sont pas uniformes d’un paquet à l’autre.
Un paquet peut avoir de nombreuses versions. Chacune peut définir ses propres dépendances, licences, auteurs, son type, sa stabilité et ses règles de remplacement.
Le code de modélisation agrège les versions en propriétés et listes de relations au niveau du paquet.
Le modèle suit une règle :
Préserver les métadonnées propres à chaque version, tout en exposant des indicateurs au niveau du paquet pour l’analyse du graphe.
PHP Packages Graph utilise des modèles Pydantic pour valider et structurer les données des paquets avant leur import dans Neo4j.
Le modèle comprend des objets au niveau du paquet, tels que :
Package

Downloads

Maintainer

Author

Version
Le modèle Version recueille notamment les champs Composer suivants :
require

require_dev

suggest

conflict

provide

replace

license

authors

version

version_normalized

abandoned
Le modèle Package agrège ensuite ces champs sur l’ensemble des versions.
Indicateurs agrégés des paquets
Le modèle calcule des valeurs au niveau du paquet, telles que :
aggregate_versions()

aggregate_licenses()

aggregate_authors()

aggregate_require()

aggregate_require_dev()

aggregate_suggest()

aggregate_conflict()

aggregate_provide()

aggregate_replace()

has_stable_version()

last_updated_time()

is_custom_type()
Python prépare les propriétés et les listes de relations avant l’import. Les requêtes Cypher peuvent ensuite lire un nœud de paquet sans parcourir chaque version brute.
Mise en correspondance des relations de dépendance
La couche de mise en correspondance des dépendances crée des relations explicites dans le graphe à partir des métadonnées Composer :
REQUIRES

DEV_REQUIRES

CONFLICTS

PROVIDES

REPLACES

SUGGESTS
Les dépendances d’exécution et de développement restent séparées. Un paquet fréquent dans require-dev peut servir aux tests, à l’analyse statique, aux normes de code ou au débogage sans intervenir en production.
En séparant ces types de relations, PHP Packages Graph peut répondre à des questions plus précises :
Une table à plat devrait reconstruire ces relations typées pour chaque requête.
Pourquoi la conception de la modélisation est importante
La couche de modélisation simplifie les données de Packagist sans perdre les distinctions utilisées dans l’analyse.
L’import conserve les distinctions Composer utilisées par les questions de recherche.
PHP Packages Graph conserve les distinctions importantes :
Le graphe conserve l’identité, le fournisseur, les types de dépendances, la maintenance, les licences et la stabilité des versions.
Couche d’analyse
Une fois le graphe construit, Cypher devient l’interface de recherche.
La couche d’analyse interroge directement le graphe sur des questions à l’échelle de l’écosystème.
La couche d’analyse suit une règle :
Transformer les métadonnées des paquets en questions à l’échelle de l’écosystème.
Le projet comprend des requêtes Cypher sur la répartition des licences, les paquets les plus requis, les dépendances de développement, les paquets présents dans les deux catégories de dépendances, les téléchargements, les moyennes par auteur, les années de publication et les paquets maintenus sur une longue période.
Ces requêtes ne sont pas de simples vérifications de la base de données. Elles représentent l’orientation de recherche du projet.
Répartition des licences
Les licences constituent l’un des indicateurs les plus importants à l’échelle de l’écosystème.
Le graphe peut répondre aux questions suivantes :
C’est important, car les licences influencent l’adoption, la conformité, la redistribution et les risques pour les organisations.
Un graphe de dépendances dépourvu d’analyse des licences ne donne qu’une vision partielle.
Influence des dépendances
La question la plus importante pour le graphe concerne l’influence des paquets.
Un paquet qui reçoit de nombreuses relations REQUIRES est structurellement important, car beaucoup d’autres paquets en dépendent.
Le graphe peut répondre aux questions suivantes :
Cette analyse révèle la couche d’infrastructure de l’écosystème PHP.
Certains paquets peuvent sembler peu visibles en tant que produits, alors qu’ils sont profondément intégrés à la chaîne d’approvisionnement logicielle. Ils méritent une attention particulière, car leur maintenance, leur stabilité et leur sécurité affectent de nombreux projets en aval.
Téléchargements et centralité des dépendances
Les téléchargements et la centralité des dépendances sont liés, mais ne mesurent pas la même chose.
Les téléchargements mesurent le volume d’utilisation.
Les relations de dépendance entrantes mesurent l’influence structurelle.
Un paquet peut compter de nombreux téléchargements parce que beaucoup de projets l’installent directement. Un autre peut être structurellement important parce qu’il soutient d’autres paquets populaires.
PHP Packages Graph permet de comparer ces indicateurs au lieu de réduire la popularité à une seule dimension.
C’est important, car la santé d’un écosystème dépend à la fois de son infrastructure visible et invisible.
Stabilité et maintenance
Le projet étudie aussi la stabilité et la maintenance à partir de champs tels que :
has_stable_release

published_at

updated_at

abandoned

versions
Ces champs aident à répondre à des questions comme :
Les métadonnées des paquets deviennent ainsi des indicateurs de pérennité.
La taille ne suffit pas à déterminer la santé d’un écosystème de dépendances. Celui-ci est sain lorsque ses paquets importants sont maintenus, stables, compréhensibles et utilisables dans un cadre légal clair.
Exemples de requêtes
Le projet utilise des requêtes Cypher pour explorer le graphe.
Par exemple, la répartition des licences peut être interrogée avec :
MATCH (p:Package)

UNWIND p.licenses AS license

RETURN license, COUNT(p) AS package_count

ORDER BY package_count DESC;
Les principales dépendances d’exécution peuvent être interrogées avec :
MATCH (:Package)-[:REQUIRES]->(p:Package)

RETURN p.full_name AS package, COUNT(*) AS times_required

ORDER BY times_required DESC

LIMIT 100;
Les principales dépendances de développement peuvent être interrogées avec :
MATCH (:Package)-[:DEV_REQUIRES]->(p:Package)

RETURN p.full_name AS package, COUNT(*) AS times_required

ORDER BY times_required DESC

LIMIT 100;
Les paquets importants à la fois pour l’exécution et le développement peuvent être interrogés avec :
MATCH (p:Package)

OPTIONAL MATCH (:Package)-[:REQUIRES]->(p)

WITH p, COUNT(*) AS required_count

OPTIONAL MATCH (:Package)-[:DEV_REQUIRES]->(p)

WITH p, required_count, COUNT(*) AS dev_required_count

WHERE required_count > 0 AND dev_required_count > 0

RETURN p.full_name, required_count, dev_required_count

ORDER BY required_count DESC, dev_required_count DESC

LIMIT 10;
Les anciens paquets toujours maintenus peuvent être interrogés avec :
MATCH (p:Package)

WHERE (p.abandoned IS NULL OR p.abandoned = false)

  AND p.published_at IS NOT NULL

  AND p.updated_at IS NOT NULL

WITH DISTINCT p,

     duration.between(datetime(p.published_at), datetime(p.updated_at)) AS lifespan

ORDER BY lifespan.years DESC

LIMIT 10

RETURN DISTINCT p.full_name AS package_name, p.published_at, p.updated_at, lifespan.days;
Grâce à ces requêtes, le graphe devient un outil de recherche, et non un simple système de stockage.
Notebook de recherche et figures
Le dépôt comprend également un notebook et des figures, en cohérence avec l’orientation du projet.
Le code ne se limite pas à un importateur. Il constitue aussi un environnement de recherche exploratoire.
Le notebook permet d’examiner les résultats, de créer des graphiques, de comparer des mesures et de transformer les requêtes du graphe en explications visuelles.
Le notebook transforme les résultats exportés en graphiques, tableaux et notes de recherche.
Le processus de recherche se présente ainsi :
Chaque figure peut être reliée au résultat de requête qui la produit.
Principales décisions d’ingénierie
Partir de la question sur l’écosystème, pas de l’outil
Le projet est parti d’une question de recherche :
À quoi ressemble l’écosystème PHP lorsque les paquets Packagist sont modélisés sous forme de graphe de dépendances ?
La question demande des relations de dépendance typées. Neo4j stocke donc le jeu de données importé sous forme de graphe.
Utiliser une base orientée graphe pour les relations de dépendance
Les écosystèmes de paquets sont des réseaux.
Un paquet peut en requérir, suggérer, remplacer ou fournir un autre, ou entrer en conflit avec lui. Il s’agit de relations, pas seulement de colonnes.
Neo4j stocke chaque type de relation Composer comme une arête que Cypher peut compter ou parcourir.
Séparer la collecte de l’import
Le collecteur écrit un jeu de données JSON local avant l’entrée des données dans Neo4j.
Les fichiers locaux permettent de relancer l’import sans dépendre de la disponibilité de Packagist.
Garder des types de relations explicites
Le projet ne réduit pas toutes les arêtes à une relation générique DEPENDS_ON.
Il conserve séparément les types de relations de Composer :
REQUIRES

DEV_REQUIRES

CONFLICTS

PROVIDES

REPLACES

SUGGESTS
Cette séparation évite de mélanger l’influence en production et en développement dès la première analyse.
Agréger les métadonnées des paquets avant leur insertion dans le graphe
Le modèle Pydantic agrège les licences, les auteurs, les versions, les dépendances, la stabilité et les horodatages de mise à jour avant l’écriture dans Neo4j.
Le graphe stocke les valeurs agrégées utilisées par les requêtes, pas toute la réponse imbriquée de Packagist.
Utiliser Cypher comme interface de recherche
Cypher exprime des questions comme "paquets les plus requis" et "paquets requis en production et en développement" par la correspondance d’arêtes typées.
Préparer l’utilisation d’algorithmes de graphe
La configuration de Neo4j comprend le plugin Graph Data Science pour de futures mesures structurelles.
L’étape suivante naturelle consiste à calculer :
Le projet passerait ainsi d’une analyse descriptive à une recherche structurelle sur l’écosystème.
Considérer la maintenance comme un indicateur de l’écosystème
Le projet ne se limite pas aux téléchargements ou au nombre de dépendances.
Il intègre aussi des champs tels que le statut d’abandon, les dates de publication et de mise à jour, la présence d’une version stable, les versions et le type de paquet.
C’est important, car la santé d’une dépendance ne dépend pas seulement de sa popularité.
Un paquet abandonné dont dépendent de nombreux projets représente un risque. Un ancien paquet toujours maintenu constitue une infrastructure. Un paquet sans version stable peut être utile, mais il transmet un autre type d’indicateur d’adoption.
Ce que j’ai appris
La principale leçon de PHP Packages Graph est que les installations directes ne montrent qu’une partie de l’écosystème. Un paquet enfoui dans les arbres de dépendances peut soutenir de nombreuses applications sans apparaître dans leur configuration principale. Le graphe rend cette position interrogeable.
Les métadonnées gagnent aussi en utilité lorsqu’elles sont reliées. Une licence, un nombre de téléchargements ou un indicateur d’abandon prend davantage de sens lorsqu’on le compare aux dépendances entrantes.
Par exemple, un paquet abandonné avec peu de dépendants pose un certain type de problème. Un paquet abandonné qui reçoit des milliers de relations de dépendance en pose un tout autre.
Le projet a aussi montré que la recherche sur un écosystème dépend de la préparation des données. Packagist imbrique des métadonnées inégales entre les versions. Pydantic valide ces enregistrements, puis l’importateur les normalise et les agrège avant l’analyse.
Neo4j change les questions que je peux poser lorsque les paquets deviennent des nœuds et chaque type de dépendance Composer une arête explicite.
Recherche en cours
Le projet collecte désormais les données de Packagist de manière incrémentale, conserve une copie locale des sources, normalise les métadonnées entre les versions et importe dans Neo4j des relations de dépendance explicites. Les requêtes Cypher et les notebooks portent sur les licences, le nombre de dépendances, les téléchargements, la stabilité des versions et les dates de maintenance.
La prochaine étape utile consiste à publier un jeu de données daté et à calculer des mesures comme PageRank, l’intermédiarité et la détection de communautés. L’analyse pourrait alors dépasser les comptes descriptifs pour étudier l’importance structurelle et les risques de maintenance.