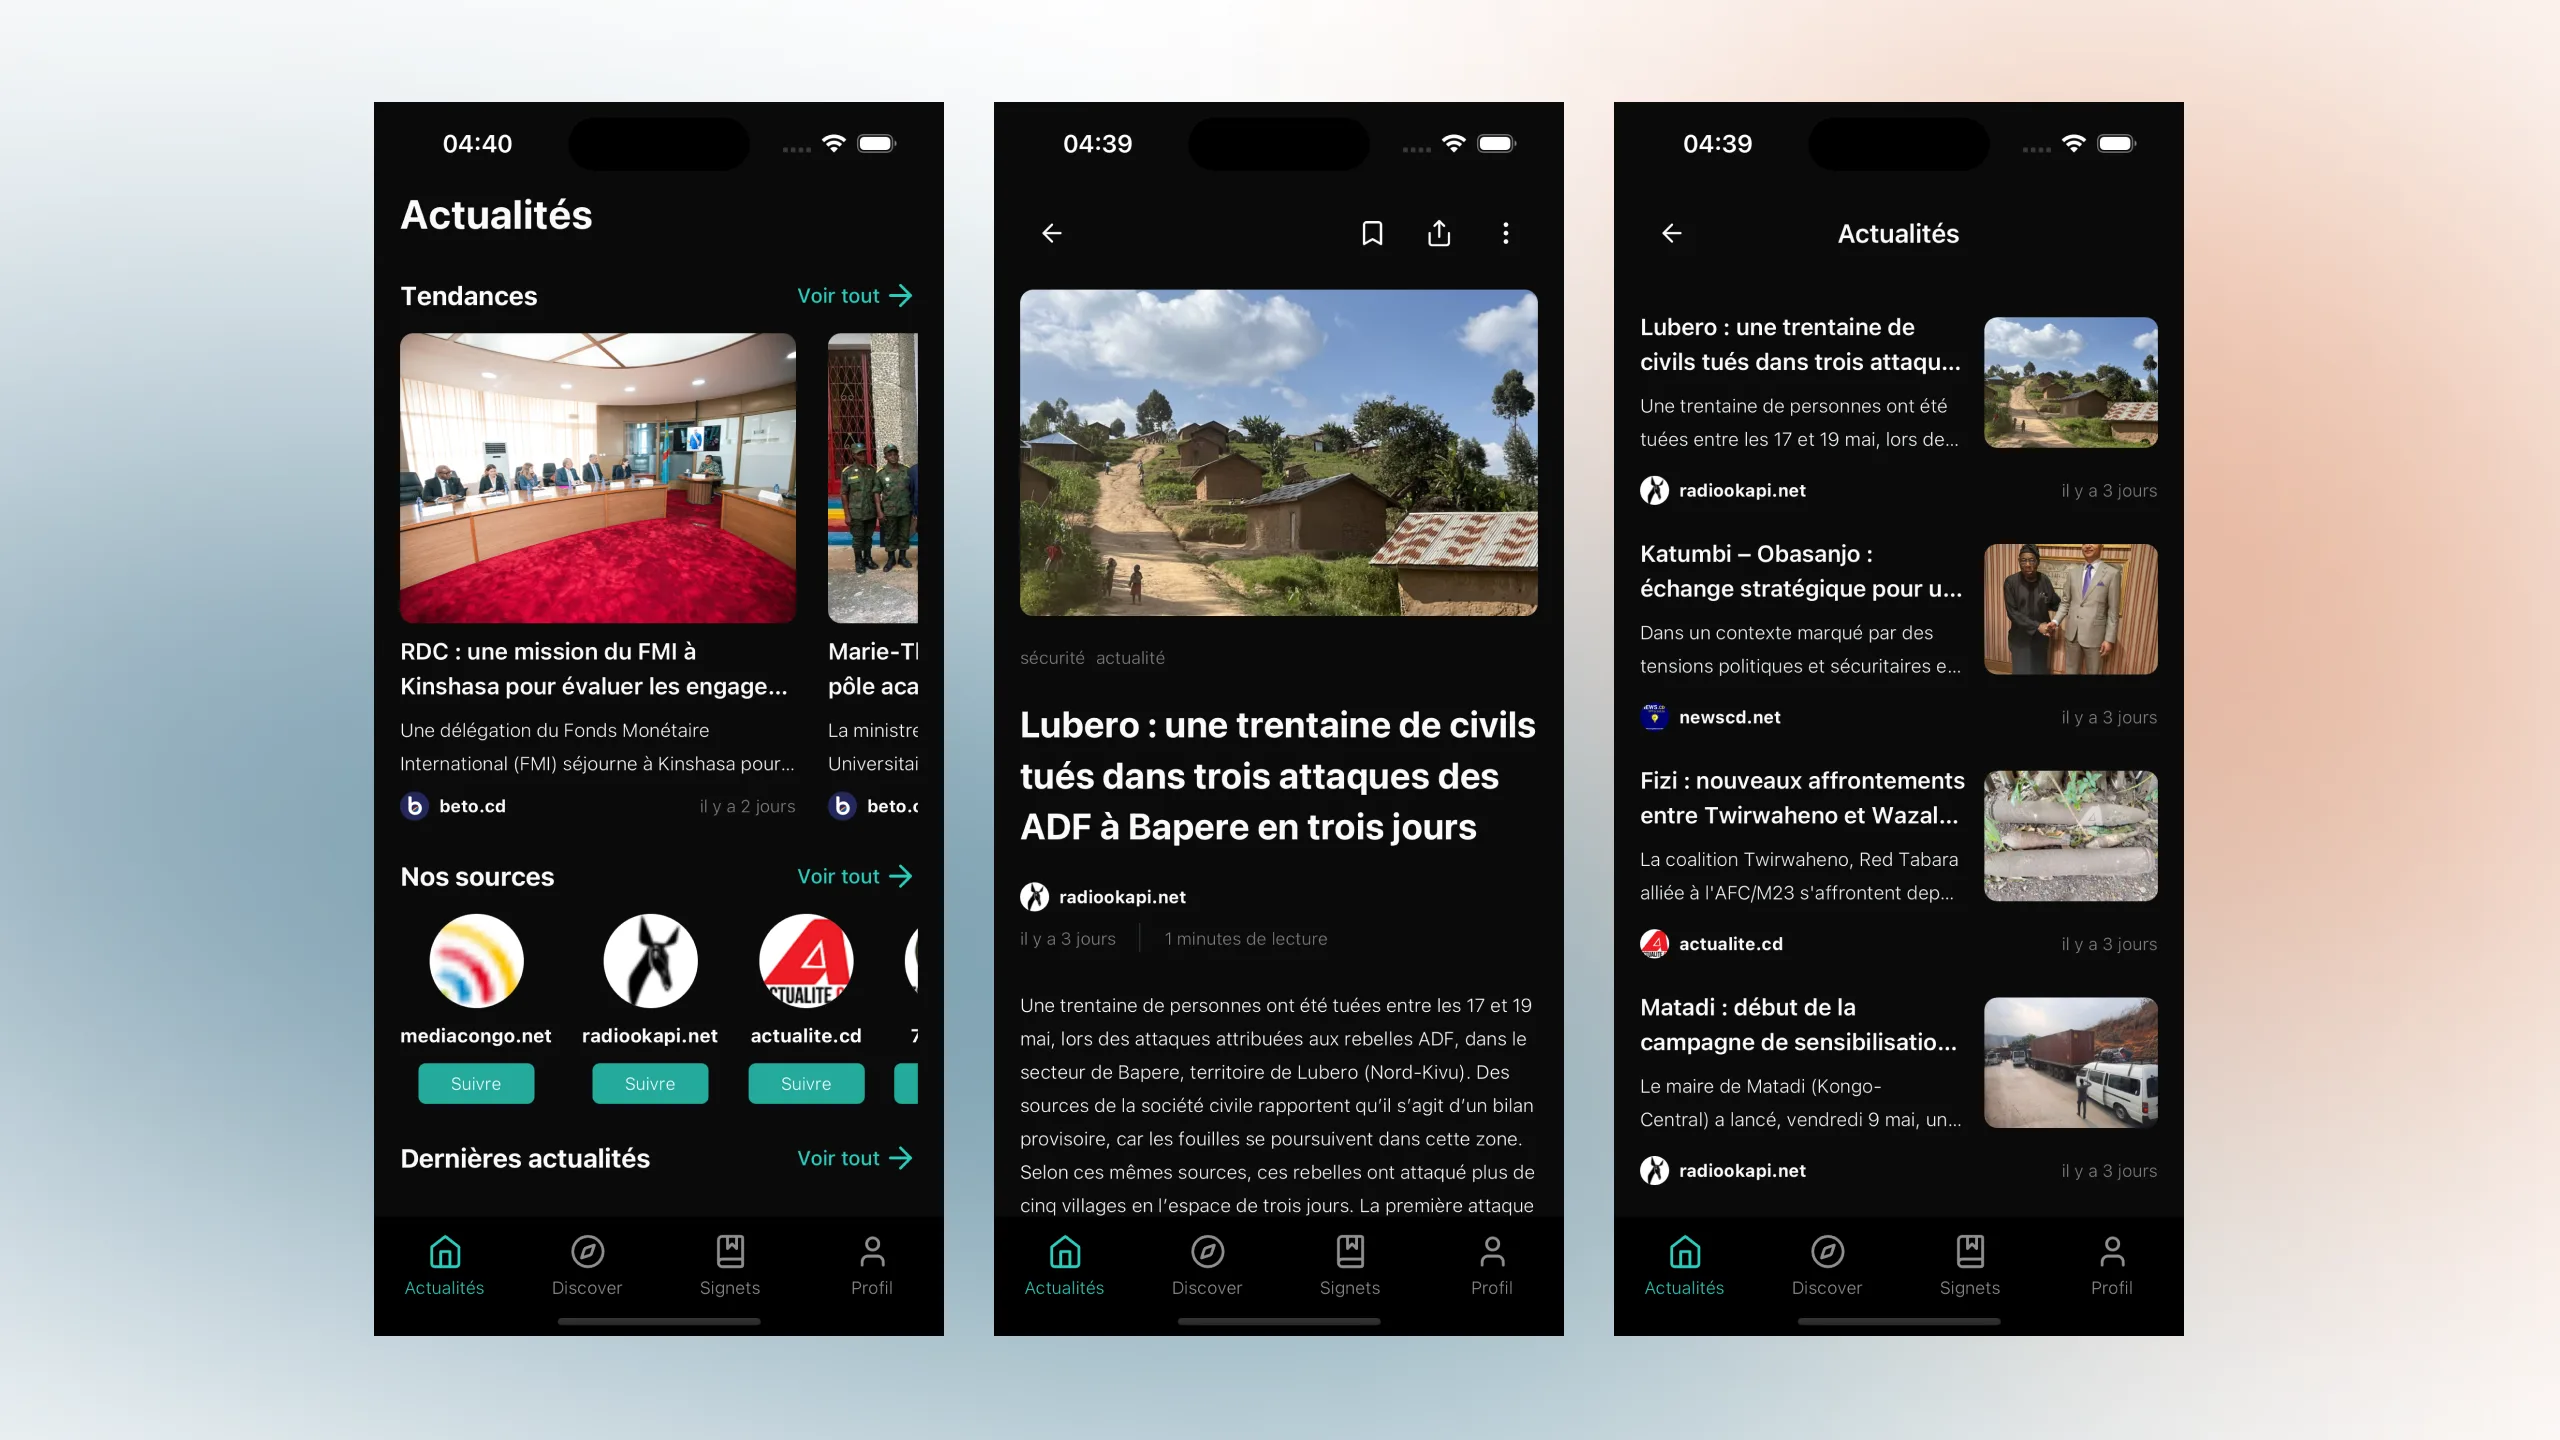
J’ai commencé Basango parce que suivre la guerre et la situation sécuritaire dans l’est de la RDC demandait de consulter de nombreuses sources à la main. Les reportages étaient dispersés sur des sites aux catégories, formats de dates et modes de publication différents. Une fois un article sorti de la page d’accueil, le retrouver pouvait demander une nouvelle recherche.
J’ai construit une collection commune en conservant le média, le lien original, la date de publication et le contenu extrait de chaque article. L’objectif est de consacrer moins de temps à réunir les reportages et davantage à les comparer. Cette collection fournit aussi une base pour des analyses ultérieures, mais la présence d’un article dans Basango ne valide ni ses affirmations ni la crédibilité de son éditeur.
La première implémentation utilisait un collecteur TypeScript, des fichiers JSONL locaux et un tableau de bord Next.js. J’ai depuis isolé le collecteur dans une application Rust et migré le tableau de bord vers TanStack Start. Le changement le plus conséquent concerne le suivi du travail inachevé : un article peut attendre localement sa transmission, puis attendre son indexation dans PostgreSQL une fois accepté par l’API.
Basango Crawler prend en charge la collecte. Il extrait et normalise les articles, les enregistre dans SQLite, puis les transmet à l’API. Il fonctionne indépendamment de l’espace de travail Bun de Basango, qui contient l’API Hono, le tableau de bord, le lecteur mobile et les paquets partagés.
Dans l’application, PostgreSQL conserve la copie de référence de chaque article. Meilisearch en contient une copie destinée à la recherche, qui peut être reconstruite. Le tableau de bord TanStack Start et le lecteur Expo accèdent aux données par tRPC ; les clients MCP disposent d’une interface distincte en lecture seule. Drizzle ORM gère la persistance PostgreSQL de l’application.
Le schéma suivant représente le parcours des articles dans le système actuel. Les files de tâches et le suivi d’exploitation ont des rôles distincts, détaillés plus loin.
Mermaid
L’interface HTTP permet au collecteur de transmettre les articles sans accès direct à la base. Les clients utilisent, à leur tour, des contrats d’API validés sans importer la couche de persistance. À chacun de ces échanges, une requête en échec doit pouvoir être reprise sans recommencer toute la collecte.
Je maintiens une configuration pour 30 sources : 6 sources HTML et 24 sources WordPress. La disponibilité et la couverture des archives restent à mesurer pour chacune.
Les sources HTML déclarent les sélecteurs des listes, liens, titres, corps, dates et éléments de pagination. Les sources WordPress utilisent des réponses REST structurées. Les deux adaptateurs produisent des articles intermédiaires soumis à la même étape de normalisation.
Quatre sources déclarent des catégories indexées et demandent une collecte par catégorie. Les intervalles de pages, les périodes et les directions de collecte permettent de cibler les nouveautés ou les archives. Le collecteur peut demander à l’API les bornes de publication déjà collectées, y compris pour une catégorie précise d’une source.
La validation de configuration rejette les identifiants de source dupliqués, les noms de files identiques et les incohérences entre catégories et pagination. Les sélecteurs et les règles de pagination restent propres aux sources ; le déroulement de la collecte est partagé.
La normalisation rejette les titres et les corps vides, nettoie les caractères invisibles et les espaces, puis supprime les catégories répétées sans distinguer les majuscules des minuscules. Chaque article conserve son identifiant de source, son URL, sa date de publication et les métadonnées disponibles.
Le collecteur calcule une empreinte MD5 de l’URL comme identité stable. Elle sert à rendre le stockage et la transmission répétables ; ce n’est pas un mécanisme de sécurité. Deux copies du même reportage publiées à des URL différentes restent deux enregistrements distincts.
J’utilise la collecte directe pour examiner l’extraction et effectuer des collectes ponctuelles. Pour les traitements en arrière-plan, l’exécutable prend aussi en charge des files Redis via le client Rust BullMQ. Tokio fournit le moteur asynchrone, Reqwest les requêtes HTTP et Scraper l’analyse HTML.
Le traitement avec files comporte trois étapes :
La découverte trouve les articles candidats dans les listes ou les réponses d’API.
Le traitement extrait et normalise le contenu, puis l’enregistre localement.
La transmission lit l’article enregistré et l’envoie à l’API d’ingestion de Basango.
Les files Redis sont propres à un identifiant d’agent. Chaque machine doit avoir son identifiant, car les tâches de transmission désignent des articles présents dans la base SQLite locale de cet agent. Une tâche de transmission doit donc parvenir à l’agent qui détient son article, même lorsque plusieurs agents fonctionnent en parallèle.
Les requêtes HTTP disposent de délais d’expiration, d’un nombre limité de tentatives et de délais croissants entre celles-ci, avec prise en charge de Retry-After. Une source peut imposer une limitation du rythme des requêtes. Ces mécanismes traitent les défaillances temporaires ; un sélecteur HTML devenu invalide demande toujours une intervention.
Une fois extrait, un article doit être conservé même si l’API est indisponible ou si le worker redémarre. J’ai remplacé JSONL par une base de travail SQLite qui stocke le contenu, l’état de transmission, les tentatives et les erreurs. Le worker enregistre l’article avant de planifier sa transmission. Il conserve aussi l’intention de l’envoyer, ce qui permet de reprendre un ajout interrompu dans la file Redis.
Mermaid
Une tâche de transmission peut relancer la requête vers l’API sans télécharger à nouveau la page du média. Les articles déjà marqués comme transmis sont reconnus si une tâche se répète. Le mécanisme couvre aussi le cas où l’API a enregistré l’article sans que sa réponse atteigne le collecteur : la requête suivante retrouve l’article existant.
Cette conception dépend de la conservation des données SQLite de l’agent. Redis planifie les tâches ; il ne remplace pas le contenu des articles enregistré localement.
Le collecteur dispose d’archives Linux pour x86-64 et ARM64, avec un mode de déploiement adapté au Raspberry Pi 5. Un service systemd gère le processus worker. La planification reste une action explicite, effectuée par la CLI ou par cron.
Un arrêt propre laisse les tâches actives se terminer et conserve les exécutions incomplètes pour leur reprise. Des échecs répétés de connexion à Redis provoquent l’arrêt du worker afin que systemd puisse le redémarrer. La CLI propose aussi la synchronisation des sources, l’inspection des files et des articles en attente, ainsi que la relance manuelle des transmissions.
Le collecteur Rust peut être déployé comme un exécutable natif, indépendamment de l’application web. Ce changement de déploiement est établi ; je n’ai pas publié de comparaison de vitesse ou de consommation mémoire avec la version TypeScript précédente.
Une nouvelle tentative laisse une ambiguïté : l’API peut avoir enregistré l’article sans que sa réponse soit parvenue au collecteur. Je traite ce cas au point d’entrée de l’ingestion. L’ingestion demande un identifiant machine et un en-tête Idempotency-Key correspondant à l’empreinte de l’URL. L’API valide cette identité, puis utilise une contrainte unique PostgreSQL et une insertion atomique avec gestion des conflits.
Une requête répétée renvoie l’article de référence en indiquant qu’aucun nouvel enregistrement n’a été créé. Cela évite les doublons dus aux nouvelles tentatives ou au chevauchement des collectes. Ce mécanisme ne fusionne pas les reportages liés et ne met pas automatiquement à jour le contenu d’un article existant.
Le classificateur associe les libellés normalisés des catégories des médias aux catégories configurées dans Basango. Les correspondances contribuent à un score pondéré, des règles déterministes départagent les égalités et une catégorie de repli accueille les articles sans correspondance.
Je peux consulter et modifier ces correspondances dans la configuration des catégories. Les règles portent sur les libellés des médias plutôt que sur le sens du corps des articles. Un libellé absent ou trompeur peut produire une mauvaise affectation ; la qualité doit donc être évaluée sur des exemples vérifiés.
PostgreSQL fournit les listes et les détails des articles. Les recherches textuelles explicites passent par Meilisearch, dont les documents contiennent les informations de l’article, de sa source et de sa catégorie. Chaque résultat évite ainsi une lecture supplémentaire en base.
La recherche introduit une nouvelle étape de transmission. J’enregistre l’article et sa tâche d’indexation dans la même transaction PostgreSQL, puis le système tente l’indexation après validation. Un échec de recherche ne remet donc pas en cause une ingestion réussie : la mise à jour reste disponible pour une synchronisation ultérieure.
Une reconstruction complète parcourt les articles par identifiant, envoie des lots limités en taille vers un index temporaire, vérifie le nombre de documents, puis échange cet index avec celui utilisé par les clients. L’index actif n’est pas vidé au début de l’opération. Les modifications des informations affichées pour une source ou une catégorie déclenchent aussi la réindexation des documents concernés.
Le compromis est une cohérence différée : un article peut être disponible dans PostgreSQL avant d’apparaître dans la recherche. Meilisearch ajoute également un service à exploiter et un index à surveiller et à réparer.
Le tableau de bord me permet d’examiner la collection et son activité. Il donne accès aux articles, à la gestion des sources et catégories, aux rapports de publication, à l’administration des utilisateurs et au suivi de l’ingestion. Les tableaux et graphiques présentent les données par source, catégorie et période.
J’ai migré l’application web vers TanStack Start avec Vite et Nitro. TanStack Router gère les routes, les contrôles d’accès, les paramètres et le préchargement. Les modules fonctionnels contiennent les écrans et leurs interactions, tandis que TanStack Query et tRPC gèrent les données serveur.
Better Auth gère les identifiants, les sessions et la réinitialisation des mots de passe. Le tableau de bord exige le rôle administrateur. L’application mobile partage le système d’identité sans recevoir les droits d’administration.
Pour examiner une collecte, j’ai besoin de distinguer un lien découvert d’un article parvenu dans PostgreSQL. Les écrans suivent donc séparément les articles découverts, traités, enregistrés localement, ignorés, transmis et en échec.
Le collecteur fournit ces chiffres par des signaux de présence et de cycle de vie des exécutions, avec des identifiants stables et des compteurs absolus. L’API valide les signaux et conserve les états des agents, des exécutions et des activités. Elle construit la vue d’exploitation à partir de ces données ; le collecteur n’a donc pas besoin de connaître l’organisation des écrans.
Mermaid
La vue d’ensemble de l’ingestion reçoit des notifications SSE regroupées qui indiquent quelles données ont changé. Elle actualise ensuite les requêtes tRPC concernées. Le flux sert à signaler les changements ; les données persistées restent la référence.
Si ce flux se déconnecte, l’interface signale la perte de connexion et conserve le dernier état reçu. Elle actualise les données à la reconnexion. Les vues détaillées des agents et des exécutions actives utilisent, séparément, des actualisations périodiques. L’historique d’exploitation peut être purgé sans supprimer les articles.
L’application Expo et React Native comprend la consultation et le détail des articles, la recherche, le suivi des sources, les collections de favoris et les commentaires. Son intégration de session native utilise SecureStore. Elle partage les contrats de domaine et l’API typée du tableau de bord, tout en conservant sa navigation et ses composants natifs dans l’application mobile.
Les fonctions de lecture décrites ici sont implémentées dans le dépôt. Cette étude ne permet pas d’établir leur disponibilité sur les boutiques d’applications ni leur adoption par des utilisateurs.
L’API expose aussi six outils MCP en lecture seule : list_articles, search_articles, get_article, list_sources, get_source et list_categories. Ils réutilisent les requêtes de données du lecteur et le service de recherche. Un jeton Bearer dédié contrôle l’accès MCP indépendamment de l’ingestion.
Un client MCP peut parcourir ou interroger la collection, puis obtenir le corps enregistré d’un article et son lien original. Le serveur demande aux clients de conserver l’attribution des sources et d’interpréter les dates relatives dans le fuseau Africa/Lubumbashi. Il n’expose ni modifications administratives ni actions de lecteur telles que l’ajout de commentaires.
Les mécanismes de reprise permettent de distinguer l’enregistrement local, l’acceptation par l’API et l’indexation. Ils laissent aussi un travail précis à surveiller : les articles en attente de transmission sur un agent et les mises à jour de l’index en attente dans PostgreSQL. Augmenter le nombre de workers ne suffirait pas, à lui seul, à résorber ces retards.
La qualité de la collecte demande une évaluation distincte. Je dois encore mesurer la couverture des 30 sources configurées, les échecs d’extraction, les transmissions en attente, le retard d’indexation et la précision des catégories sur des exemples vérifiés. Des exécutions réussies et un grand nombre d’articles ne permettent pas d’établir l’exhaustivité ou la fiabilité des informations.
L’identité fondée sur l’URL conserve aussi comme articles distincts les versions d’un même reportage publiées par plusieurs médias. La déduplication entre médias, la recherche sémantique et les recommandations personnalisées restent hors de l’implémentation actuelle décrite ici.